

오픈 웨이트 공개로 생태계 확장… ‘한국형 AI’ 차별화 본격화
[녹색경제신문 = 김지윤 기자] LG가 독자 AI 모델 ‘엑사원(EXAONE)’을 기반으로 시각 정보 처리 능력을 강화하며 글로벌 AI 모델과의 기술 경쟁을 본격화하고 있다.
LG AI연구원은 9일 멀티모달 AI 모델 ‘엑사원 4.5’를 공개했다. 해당 모델은 텍스트뿐 아니라 이미지 정보까지 동시에 이해하고 추론할 수 있는 비전-언어 모델(VLM)로, 자체 개발한 비전 인코더와 거대언어모델(LLM)을 하나의 구조로 통합한 것이 특징이다.
이번 모델은 계약서, 기술 도면, 재무제표 등 텍스트와 이미지가 혼합된 자료를 읽고 맥락을 파악할 수 있어, 산업 현장에서의 쓰임이 높을 것으로 보인다. LG는 향후 음성, 영상은 물론 물리 환경까지 이해하는 ‘피지컬 인텔리전스’로의 확장도 목표로 하고 있다고 밝혔다.
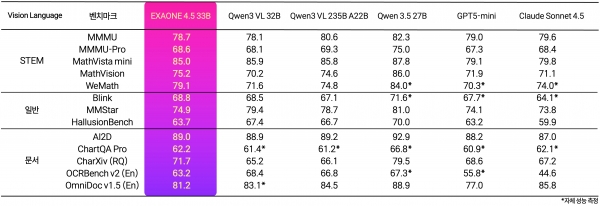
LG AI연구원에 따르면 해당 모델은 AI 시각 능력 평가 13개 지표 평균 점수에서 GPT-5 mini, Claude Sonnet 4.5, Qwen3-VL 등을 상회했다.
특히 STEM 성능 평가에서는 평균 77.3점을 기록해 주요 글로벌 모델을 앞섰고, 코딩 성능 지표인 라이브코드벤치 v6에서도 81.4점을 기록하며 Gemma 4를 넘어섰다. 차트 분석 능력을 평가하는 ChartQA Pro에서도 경쟁력 있는 점수를 확보했다.
LG 측은 “단순한 이미지 인식을 넘어 문서 속 맥락을 이해하고 질문에 답할 수 있는 수준까지 진화했다”고 설명했다.
성능뿐 아니라 효율성도 강조했다. 엑사원 4.5는 330억 개 파라미터(33B) 규모로, 기존 ‘K-엑사원’ 대비 약 7분의 1 수준이지만 텍스트 이해 및 추론 성능은 동등한 수준을 달성했다.
이는 하이브리드 어텐션 구조와 멀티 토큰 예측 기반 고속 추론 기술을 적용한 결과라는 설명이다. 지원 언어도 기존 한국어·영어 중심에서 스페인어, 독일어, 일본어, 베트남어까지 확대됐다.
LG AI연구원은 엑사원 4.5를 글로벌 플랫폼 Hugging Face에 오픈 웨이트 형태로 공개했다. 연구·학술·교육 목적에서 활용 가능하도록 하며 AI 생태계 확장을 이어간다는 전략이다.
이진식 엑사원랩장은 “엑사원 4.5는 멀티모달 AI 시대로의 전환을 보여주는 모델”이라며 “향후 음성, 영상, 물리 환경까지 이해하는 AI로 발전시켜 산업 현장에서 실제 판단과 행동이 가능한 수준까지 끌어올리겠다”고 밝혔다.
김지윤 기자 lycaon@greened.kr
